Исполнитель: Яценко Николай Константинович, 441-об.
Научный руководитель - Русинов Владислав Леонидович, СКБ "Автоматизация анализа и генерация данных".
Введение
Актуальность темы: Почему важно автоматизировать данные с помощью AI агентов.
В нынешнем времени объём обрабатываемых данных с каждым годом растет в следствии чего мы тратим большую часть времени на анализ и обработку новостных статей и публикующих новостей
Цель проекта: Разработка системы автоматического анализа и обработки данных с помощью инструментов автоматизации.
Почему выбрана данная тема: Для сведения времени на обработку и анализа данных к более продуктивному проведению
План доклада:
1 Введение
2 Анализ проблематики информационного мониторинга и существующих подходов к автоматизации сбора данных
3 Обоснование архитектуры и выбор технологического стека программного комплекса
4 Структурная схема и алгоритм функционирования системы автоматизированного парсинга и доставки информации
5 Заключение и основные выводы
6 Список использованных источников
1. ВВЕДЕНИЕ
В современном информационном обществе наблюдается экспоненциальный рост объемов данных, публикуемых в глобальной сети Интернет. Ежесуточно генерируются тысячи новостных сообщений, научно-технических статей и аналитических материалов. Для специалиста, исследователя или обучающегося оперативный мониторинг профильной информации является необходимым условием поддержания актуальности профессиональных знаний и компетенций.
Традиционный подход к информационному мониторингу, основанный на ручном просмотре множества веб-ресурсов и каналов в мессенджерах, характеризуется низкой эффективностью. Он сопряжен со значительными временными затратами и приводит к феномену «информационного шума», при котором потребление значительного объема второстепенных сведений происходит в ущерб выделению ключевой сути сообщений. Следствием этого является снижение продуктивности и повышение риска упущения критически важных событий. Автоматизация процессов сбора, первичной обработки и селекции данных позволяет нивелировать указанные недостатки, перераспределяя временные ресурсы пользователя с поиска информации на ее содержательный анализ.
Целью настоящей работы является разработка архитектуры и практическая реализация программного комплекса для автоматизированного сбора, фильтрации и доставки текстовой информации из заданных источников с использованием инструментов с открытым исходным кодом.
Актуальность темы обусловлена объективной потребностью в минимизации временных затрат на обработку входящих информационных потоков и повышении релевантности получаемых данных для конечного пользователя.
2. АНАЛИЗ ПРОБЛЕМАТИКИ ИНФОРМАЦИОННОГО МОНИТОРИНГА И СУЩЕСТВУЮЩИХ ПОДХОДОВ К АВТОМАТИЗАЦИИ СБОРА ДАННЫХ
В рамках анализа проблемной области были выявлены следующие ключевые факторы, обусловливающие необходимость создания специализированной системы:
Информационная перегрузка (Information Overload): Физические возможности человека по отслежинию обновлений на множестве информационных ресурсов ограничены, что неизбежно ведет к потере части релевантных данных. Объем генерируемой информации устойчиво превышает пропускную способность каналов ее восприятия индивидом.
Низкое семантическое качество контента: Значительная доля публикаций в новостных лентах и Telegram-каналах содержит высокий уровень «информационного шума» -- рекламные включения, элементы веб-интерфейса, отвлекающие и малозначимые подробности, которые затрудняют идентификацию основной мысли сообщения.
Недостаточная оперативность при ручном мониторинге: При неавтоматизированном подходе временной лаг между публикацией материала и его прочтением целевой аудиторией может достигать нескольких часов или даже суток, что является критическим фактором в динамично развивающихся предметных областях.
Анализ существующих на рынке решений (агрегаторы новостей, отдельные Telegram-каналы) показывает, что большинство из них либо не предоставляют возможностей тонкой настройки источников, либо не реализуют функций семантического сжатия контента («удаления воды»), либо требуют финансовых затрат на подписку. Следовательно, разработка собственного специализированного решения, лишенного указанных недостатков, представляется целесообразной.
3. ОБОСНОВАНИЕ АРХИТЕКТУРЫ И ВЫБОР ТЕХНОЛОГИЧЕСКОГО СТЕКА ПРОГРАММНОГО КОМПЛЕКСА
Принципиальным требованием к разрабатываемой системе являлась реализация с нулевой совокупной стоимостью владения, что детерминировало выбор в пользу программных продуктов с открытым исходным кодом (Open Source). Архитектура комплекса строится на следующих компонентах:
Платформа оркестрации и парсинга n8n: Данный программный продукт выступает в роли центрального элемента системы, обеспечивающего автоматизацию процессов сбора и обработки данных. n8n представляет собой low-code платформу с открытым исходным кодом, позволяющую конструировать сложные сценарии взаимодействия с веб-ресурсами без необходимости написания объемного программного кода. Функционал платформы включает выполнение HTTP-запросов, парсинг HTML-структур, обработку RSS-лент и интеграцию с широким спектром внешних сервисов через API. Выбор обусловлен возможностью бесплатного развертывания на собственной инфраструктуре (self-hosted), наличием интуитивно понятного веб-интерфейса и обширной библиотекой готовых модулей.
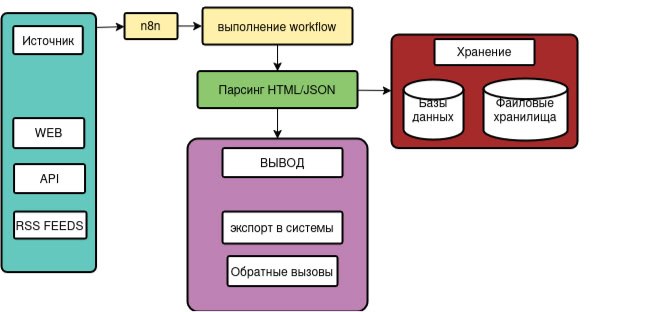
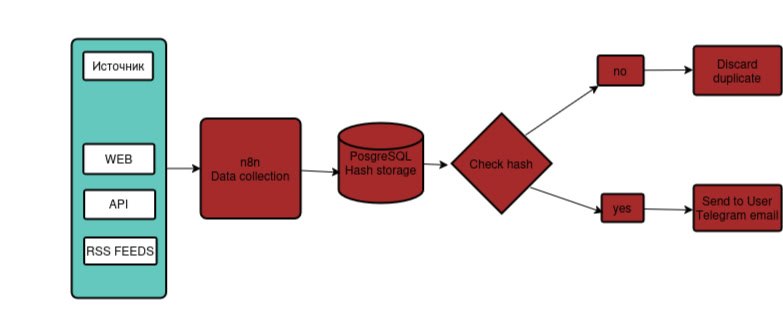
Система управления базами данных PostgreSQL: Использование реляционной СУБД является необходимым условием для обеспечения отказоустойчивости и исключения дублирования информационных сообщений. PostgreSQL выполняет функцию хранилища метаданных, а именно -- хеш-сумм (или уникальных идентификаторов) ранее обработанных и отправленных новостей. При каждом цикле сбора данных платформа n8n выполняет запрос к базе данных для верификации уникальности новой публикации. Наличие данного компонента позволяет реализовать механизм дедупликации, гарантирующий, что конечный пользователь получит каждое новое сообщение только однократно.
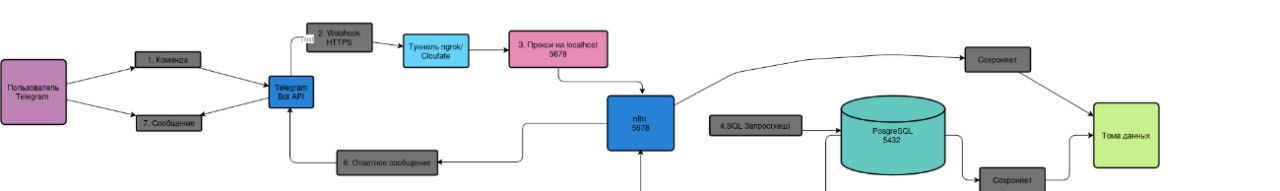
Telegram Bot API как пользовательский интерфейс: Telegram, будучи наиболее распространенной и бесплатной платформой для обмена сообщениями, избран в качестве канала доставки обработанной информации конечному пользователю. Программный интерфейс Telegram Bot API позволяет организовать асинхронную отправку сообщений от серверной части непосредственно в клиентское приложение пользователя.
Контейнеризация посредством Docker: Для обеспечения унификации среды выполнения, упрощения процесса развертывания и обновления всех компонентов системы на сервере под управлением ОС Linux (Ubuntu) используется технология контейнеризации Docker. Данный подход гарантирует изолированность и воспроизводимость программного окружения.
4. СТРУКТУРНАЯ СХЕМА И АЛГОРИТМ ФУНКЦИОНИРОВАНИЯ СИСТЕМЫ АВТОМАТИЗИРОВАННОГО ПАРСИНГА И ДОСТАВКИ ИНФОРМАЦИИ
Разрабатываемая система базируется на конвейерной модели обработки данных с использованием связки платформы автоматизации и реляционной базы данных. Обобщенный алгоритм функционирования включает следующие этапы:
Инициация сбора данных (Модуль триггеров): Функционирование системы может инициироваться по заданному временному расписанию (например, с периодичностью в 60 минут) либо в режиме, близком к реальному времени (для источников, поддерживающих технологию RSS). Платформа n8n выполняет направленные HTTP-запросы к заранее сконфигурированным URL-адресам целевых веб-ресурсов.
Экстракция и первичная обработка данных (Модуль парсинга): После получения HTML-кода веб-страницы, n8n, используя встроенные узлы для извлечения данных, осуществляет парсинг полученного документа с целью выделения релевантной информации: заголовка, даты и времени публикации, гиперссылки на первоисточник и основного текстового содержания. На данном этапе также производится фильтрация -- удаление HTML-тегов, рекламных вставок и прочих элементов, не несущих смысловой нагрузки.
Верификация уникальности (Модуль дедупликации с использованием PostgreSQL): Данный этап является критическим для обеспечения качества работы системы. Для извлеченной публикации вычисляется уникальный цифровой идентификатор (хеш-сумма) на основе заголовка или прямой ссылки. Посредством SQL-запроса к базе данных PostgreSQL выполняется проверка наличия данного идентификатора в таблице ранее отправленных сообщений.
При обнаружении совпадения выполнение сценария для данного элемента прекращается.
При отсутствии совпадения идентификатор фиксируется в базе данных, и процесс переходит к следующему этапу.
Формирование и доставка сообщения (Модуль интеграции с Telegram): Уникальная новость подвергается финальному форматированию. Для обеспечения лаконичности реализуется механизм семантического сжатия, например, ограничение объема передаваемого текста первыми N символами. Платформа n8n формирует структурированное сообщение, содержащее заголовок, краткую аннотацию и прямую ссылку на полный текст. Сформированное сообщение через Telegram Bot API направляется конечному пользователю.
5. ЗАКЛЮЧЕНИЕ И ОСНОВНЫЕ ВЫВОДЫ
В результате проведенной работы можно сформулировать следующие выводы:
Проблема информационной перегрузки и высокой доли нерелевантного контента («информационного шума») в повседневной деятельности современного специалиста является актуальной и требует инструментального решения.
Существующие типовые решения, такие как подписка на тематические Telegram-каналы или использование универсальных новостных агрегаторов, не в полной мере решают задачи оперативного мониторинга и семантической фильтрации контента.
Разработка специализированного программного комплекса на базе Open Source-инструментов (платформа оркестрации n8n, СУБД PostgreSQL) является технически реализуемой и экономически эффективной задачей, не предполагающей прямых финансовых вложений.
Предложенная архитектурная схема, включающая модуль дедупликации на основе реляционной базы данных, позволяет реализовать интеллектуального информационного агента. Данный агент не только осуществляет доставку сообщений в момент их публикации, но и гарантирует уникальность каждого сообщения, а реализованный механизм семантического сжатия текста предоставляет пользователю возможность ознакомления с сутью материала за минимальное время, что непосредственно повышает эффективность работы с информационными потоками.
6. СПИСОК ИСПОЛЬЗОВАННЫХ ИСТОЧНИКОВ
n8n Documentation [Электронный ресурс] // n8n.io. - Режим доступа:
https://docs.n8n.io.
PostgreSQL: The World's Most Advanced Open Source Relational Database [Электронный ресурс] // PostgreSQL.org. - Режим доступа:
https://www.postgresql.org/docs/.Telegram Bot API [Электронный ресурс] // Telegram. - Режим доступа:
https://core.telegram.org/bots/api Docker Documentation [Электронный ресурс] // Docker.com. - Режим доступа:
https://docs.docker.com Тоффлер Э. Шок будущего / Пер. с англ. -- М.: ООО «Издательство ACT», 2002. -- 557 с.
